大模型的运行效率,取决于底层计算算子够不够快。矩阵乘法、归一化、激活函数 —— 这些看似基础的操作,决定了计算、访存和数据复用能否充分发挥芯片的性能。让大模型写出正确的代码只是第一步,要获得更高性能,还需要在真实硬件上反复测量、识别瓶颈并调整实现。
GPU 算子优化是 AI 基础设施中最硬核的工程难题之一,也是最能检验 RL 方法通用性的练兵场。Jasper-K,是我们用 RL 全栈方法在 GPU 算子优化上交出的第一份答卷。
今天,模速入驻企业赛砥英科交出了这份答卷的成绩。
Ragentile 推出面向 GPU 算子优化的模型系列 Jasper-K。赛砥英科在某国产头部 AI 芯片上开展实验,通过多轮强化学习,让模型从“生成、执行、反馈、修订”的循环里自己学会优化策略——先写出正确实现,再在正确的基础上继续探索更快的写法。
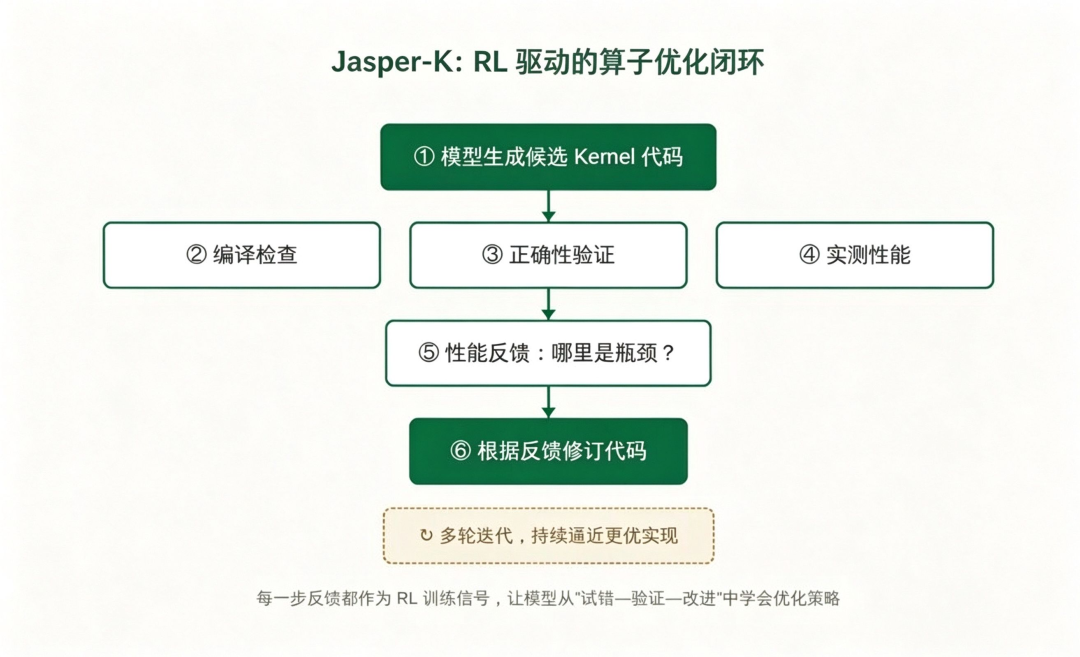
图 1|Jasper-K 的 RL 优化闭环:模型生成候选 Kernel 代码后,并行执行编译检查、正确性验证和性能实测,将瓶颈信息反馈回模型进行修订,多轮迭代持续逼近更优实现。
结果有三层:RL 后训练在多个基模上持续带来提升;27B 模型在LeetCuda任务上能与前沿模型正面竞争;算子层面的提速进一步转化为真实大模型的推理吞吐增长。
一、RL 后训练:跨基模均获正向提升
RL 后训练方法不绑定特定基模:在三个架构迥异的开源基础模型上均取得正提升,验证了方法的通用性。
Jasper-K-27B、Jasper-K-32B 和 Jasper-K-35B(MoE)分别基于 Qwen3.8-27B、QwQ-32B 和 Qwen3.6-35B-A3B 进行 RL 后训练。三套模型评测条件完全统一:同一硬件、同一套任务定义、同一套正确性检查和计时流程,每题的优化预算均为 16 条轨迹、每条最多 4 轮。
赛砥英科主要采用 METR 综合加速比来打分:在每题的优化预算内,选取最快的正确实现,若没有找到更快的就退回基线参考实现,即加速比为 1×,最后对所有题取几何平均。简单说,就是模型在规定预算内找到的最快写法,比参考实现快了几倍。
KernelBench 是由斯坦福等机构提出、学界公认的 GPU 算子优化权威评测基准。在 KernelBench 全量评测中,Jasper-K-27B 的分数从基模的 2.289× 提升至 3.471×,相对提升 51.64%;Jasper-K-32B 和 Jasper-K-35B(MoE)相较各自基模也分别提升 2.85% 和 2.83%。
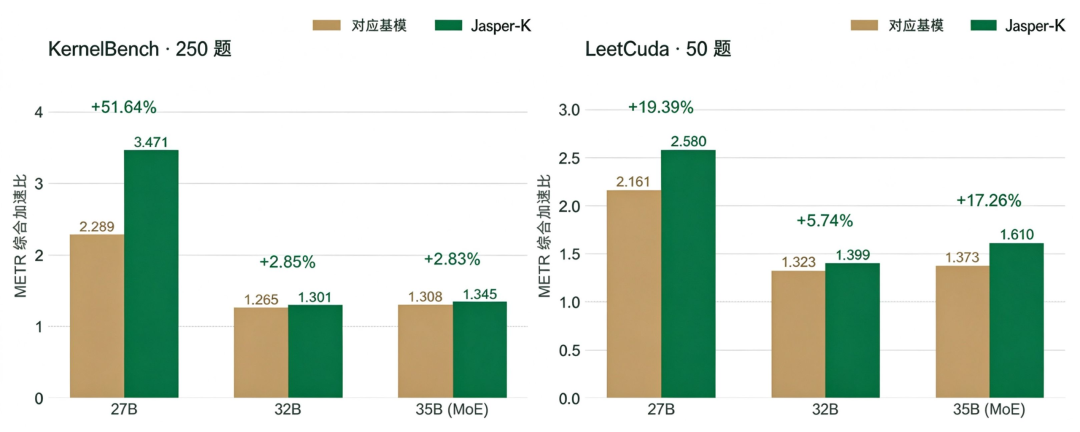
图 2|三个 Jasper-K 模型相较各自基模的提升。柱顶为 METR 综合加速比,上方百分比为相对提升。27B、32B、35B(MoE)对应的基模分别为 Qwen3.8-27B、QwQ-32B、Qwen3.6-35B-A3B。两套基准均采用每题 16×4 的优化预算。
但 KernelBench 题目是训练时见过的 —— 涨分算不算 "背答案"?赛砥英科进一步关注:这些收益能否扩展到训练任务之外。
为此,赛砥英科采用了第三方算子优化测试 bench ——LeetCuda,来检验模型的泛化能力。该测试集来自加拿大阿尔伯塔大学 RL 团队,共50题,未参与过 RL 训练或检查点选择。训练数据只用 KernelBenchFixed 的 180 道 Level 1 和 Level 2 题目,另外 20 道用于训练监控和检查点选择。上面的 KernelBench 数字来自包含训练任务的 250 题全量评测。KernelBenchFixed 修订了训练与验证集中的 21 道任务,减少模型通过恒定输出和代数捷径绕过真实计算的可能,引导模型学习真正的算子优化策略。
在 LeetCuda 上,Jasper-K-27B、Jasper-K-32B 和 Jasper-K-35B(MoE)相较各自基模的 METR 提升分别为 19.39%、5.74% 和 17.26%。这一跨基模、跨测试集的共同趋势,为 RL 后训练的有效性和向新任务迁移的能力提供了证据。
二、27B :垂直对标前沿大模型
既然 LeetCuda 的题模型训练时完全没接触过,赛砥英科就用它做一次更严格的横向对比 —— 把 Jasper-K-27B 和几个前沿大模型放在同一套条件下,看看针对算子优化做过 RL 后训练的 Jasper-K-27B,能不能追上没做过这种训练的通用大模型。这也能规避公开基准可能存在的数据污染风险,真正检验模型在新算子任务上的泛化能力。
赛砥英科将 Jasper-K-27B 与 GPT-6.1 Sol 的 medium、high 设置,以及 Claude Opus 5.5 和 DeepSeek V4.1 Flash-1017 的 high 设置放在相同的 LeetCuda 评测条件下比较。Jasper-K-27B 以 Qwen3.8-27B 的 medium 设置为起点进行 RL 后训练,所有模型用同一套执行环境、同样的 16×4 搜索预算。
Jasper-K-27B 的 METR 综合加速比达到 2.580×,较 GPT-6.1 Sol medium 设置高出 9.23%,并在本次评测中略高于 GPT-6.1 Sol high、DeepSeek V4.1 Flash-1017 high、Claude Opus 5.5 high 。
在这组独立测试上,Jasper-K 展现出与前沿大模型相抗衡的算子优化能力 —— 这一竞争力来自 RL 后训练本身,而非更大的模型规模。
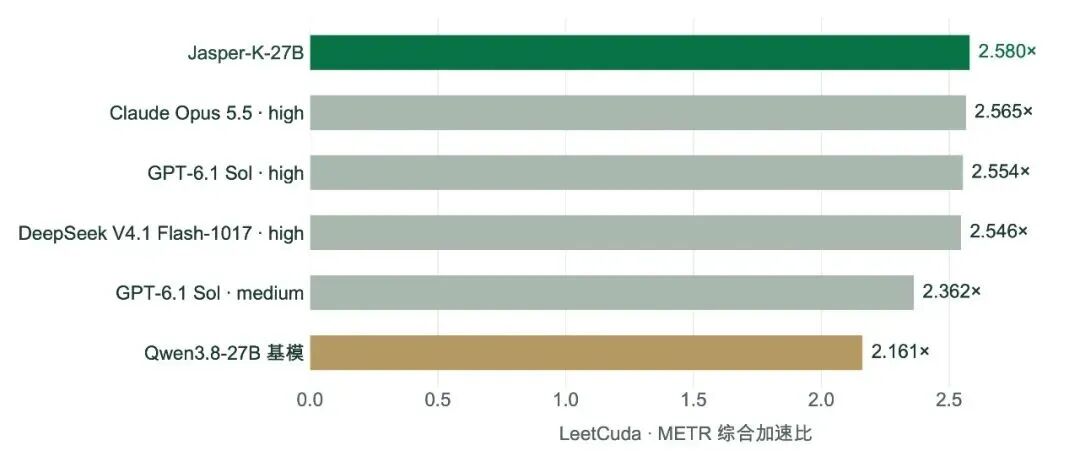
图 3|LeetCuda 上的 METR 综合加速比,按分数从高到低排列。medium/high 表示对应前沿模型的推理强度;所有模型使用相同执行环境与 16×4 搜索预算。图中保留 Qwen3.8-27B 基模,展示 RL 后训练前后的变化。
上述比较表明,在固定优化预算下,经过 RL 后训练的 27B 参数模型,算子优化表现与所评测的前沿模型相当。它真正的价值在于:竞争力可以来自训练方法,而不必依赖模型规模的扩张。当然,这一结论目前仅适用于当前硬件与这一任务范围。
三、从算子到真实吞吐:216 tokens/s
基准成绩之外,算子优化最终要落到真实模型的端到端吞吐上才有实际意义。那么,Jasper-K 优化出的算子集成到真实大模型后,端到端吞吐量究竟能提升多少?赛砥英科做了以下实测。
实验涉及两个角色:Jasper-K-27B 和 Qwen3.8-27B 负责生成候选算子,用于对比 RL 后训练前后的优化能力;被优化的算子则来自 Qwen3.8-27B。因此,在 Qwen3.8-27B 实验中,同一模型既承担被优化的工作负载,又作为生成基线算子的模型。
在 Qwen3.8-27B 的九类算子任务中,Jasper-K 相较基模生成算子的综合加速比提升 14.49%,并在九类中的七类都取得领先。最显著的是,Residual + RMSNorm 从 3.79× 提升至 7.31×,GDN norm + gate 从 4.68× 提升至 6.18×。不同算子的提升幅度并不均匀,也说明算子优化需要针对具体工作负载逐一调优,不存在通用解法。
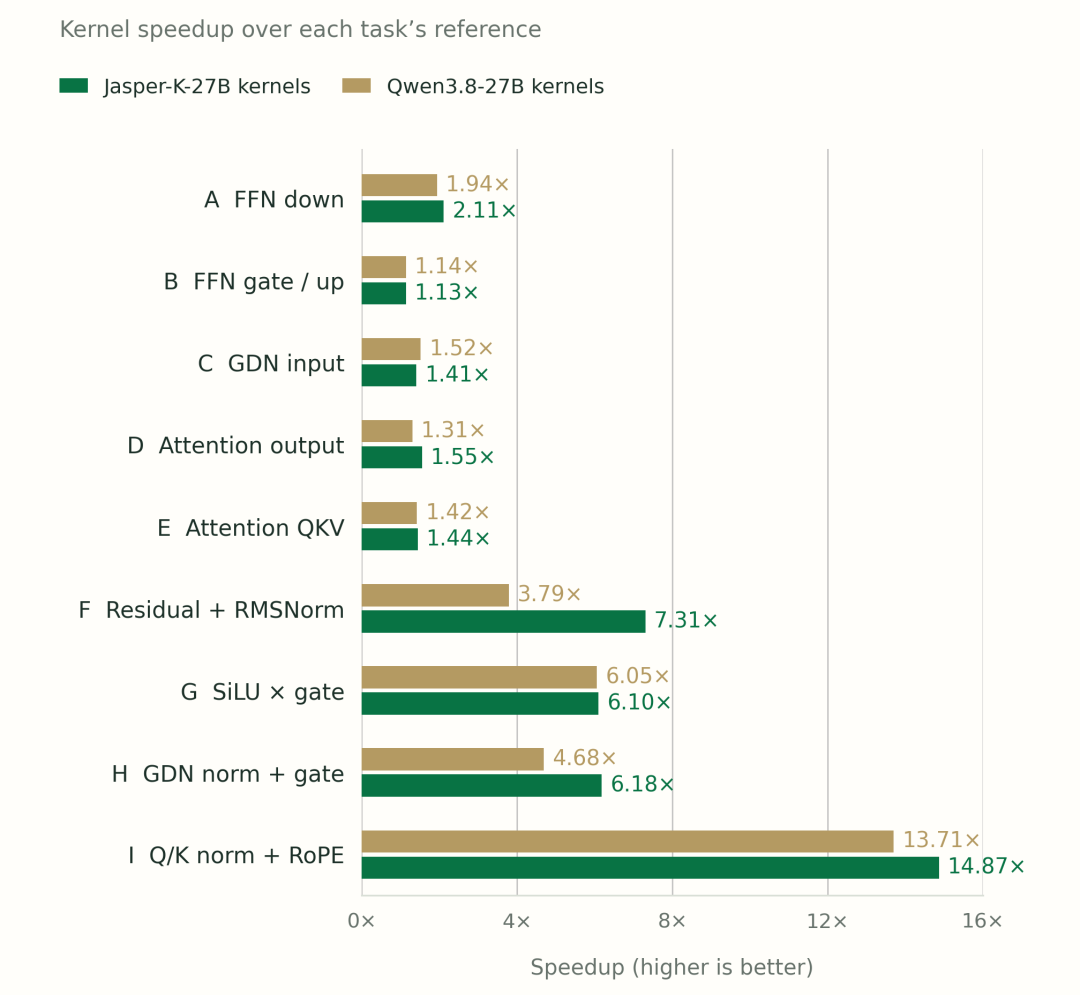
图 4|Qwen3.8-27B 的九类算子结果。绿色为 Jasper-K-27B 生成的算子,金色为 Qwen3.8-27B 生成的算子;每根柱表示相对该任务参考实现的加速比。跨算子综合提升为 14.49%。
最关键的一步:赛砥英科将生成的算子逐步集成到完整 Qwen3.8-27B 模型的推理流程中,直接测量端到端吞吐量。采用 Jasper-K 生成算子后,吞吐量达到 216.14 tokens/s:
对比 Qwen3.8-27B 生成算子的配置(207.86 tokens/s),提升 3.98%——这是 Jasper-K 带来的额外应用收益;
对比未优化的原版(168.94 tokens/s),提升 27.94%——这是整套算子优化与集成流程的收益。
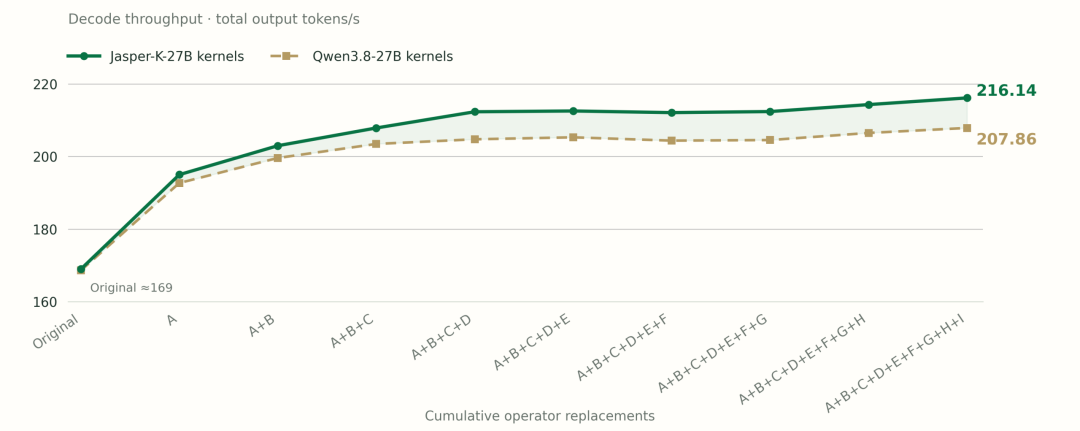
图 5|逐步集成生成算子后的 Qwen3.8-27B 实测吞吐量。横轴为累计替换的算子,A–I 与图4的算子编号对应。每个点都来自完整模型的实际运行测量;最终 Jasper-K 与基模生成算子的两种配置分别达到 216.14 和 207.86 tokens/s。
可能有人会问:前面 Qwen3.8-27B 九类算子的综合加速比提升了 14.49%,为什么装进完整模型后只涨了 3.98%?
原因在于,算子层面的 14.49% 是九类算子等权平均出来的 —— 每类算子权重相同,不考虑它在真实模型里实际占多少耗时。但在完整模型中,各类算子的运行频率和耗时占比并不相同,加上还有大量未被优化的计算同样占用时间,单个算子的大幅提升并不会等比例传导到端到端吞吐上。
3.98% 的价值在于,它是完整模型端到端实测出来的真实增益,不经过算子层面的等权平均。
从基准测试,到与前沿模型正面比较,再到真实模型推理,Jasper-K 的结果指向同一个方向:面向任务做 RL 后训练,模型确实可以学会更有效的算子优化策略,并为国产芯片上的 AI 应用带来可测量的性能收益。
更重要的是,这个过程不是一次性的。成功的优化轨迹会持续反哺训练方法与工具链,形成持续进化闭环。GPU 算子优化只是起点,这套 RL 全栈方法将走向更多 AI 基础设施场景。
来源:赛砥英科