编译:高杰
点餐时你是否会纠结——
是点常吃的稳妥菜品,
还是冒险尝试新品?
图源:Pixabay
上世纪70年代末,美国加州一家泰式餐厅里,诺贝尔物理学奖得主理查德・费曼和好友拉尔夫・莱顿共进午餐。两人已是这家餐厅的常客,莱顿陷入纠结:是直接点自己最爱的菜品,还是大胆尝试新菜?新品固然可能惊艳,却也存在味道不如熟悉菜品的风险。
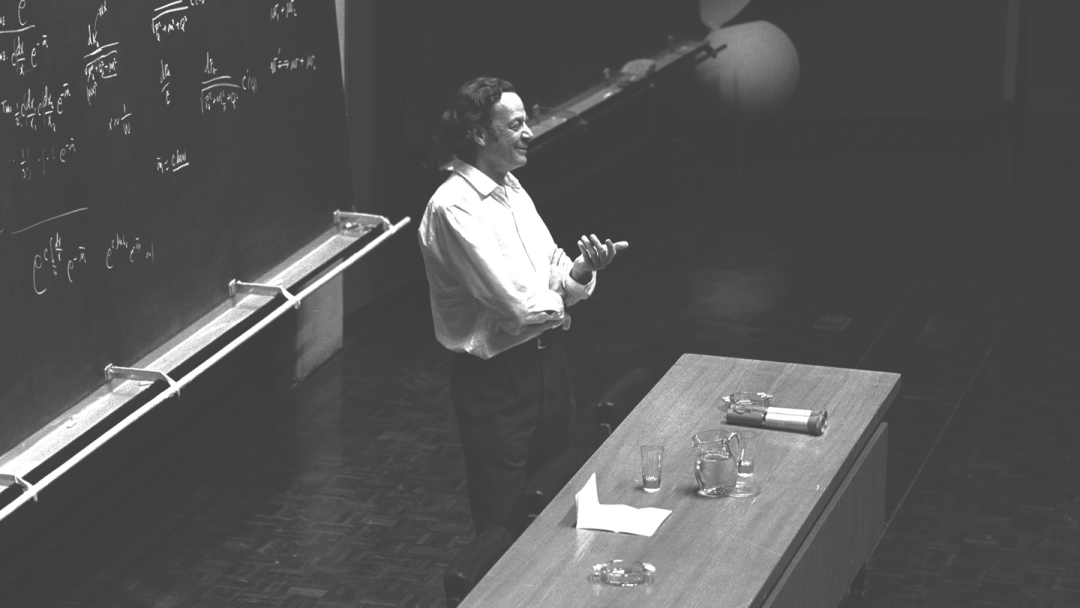
理查德·费曼 CERN PhotoLab (CC BY 4.0),参考来源[2]
这是一道经典数学难题——最优停止问题,费曼当场便在餐桌上随手演算,给出了解法。所幸莱顿保留了这份手写草稿,然而这份手稿的含义却一直是个谜。
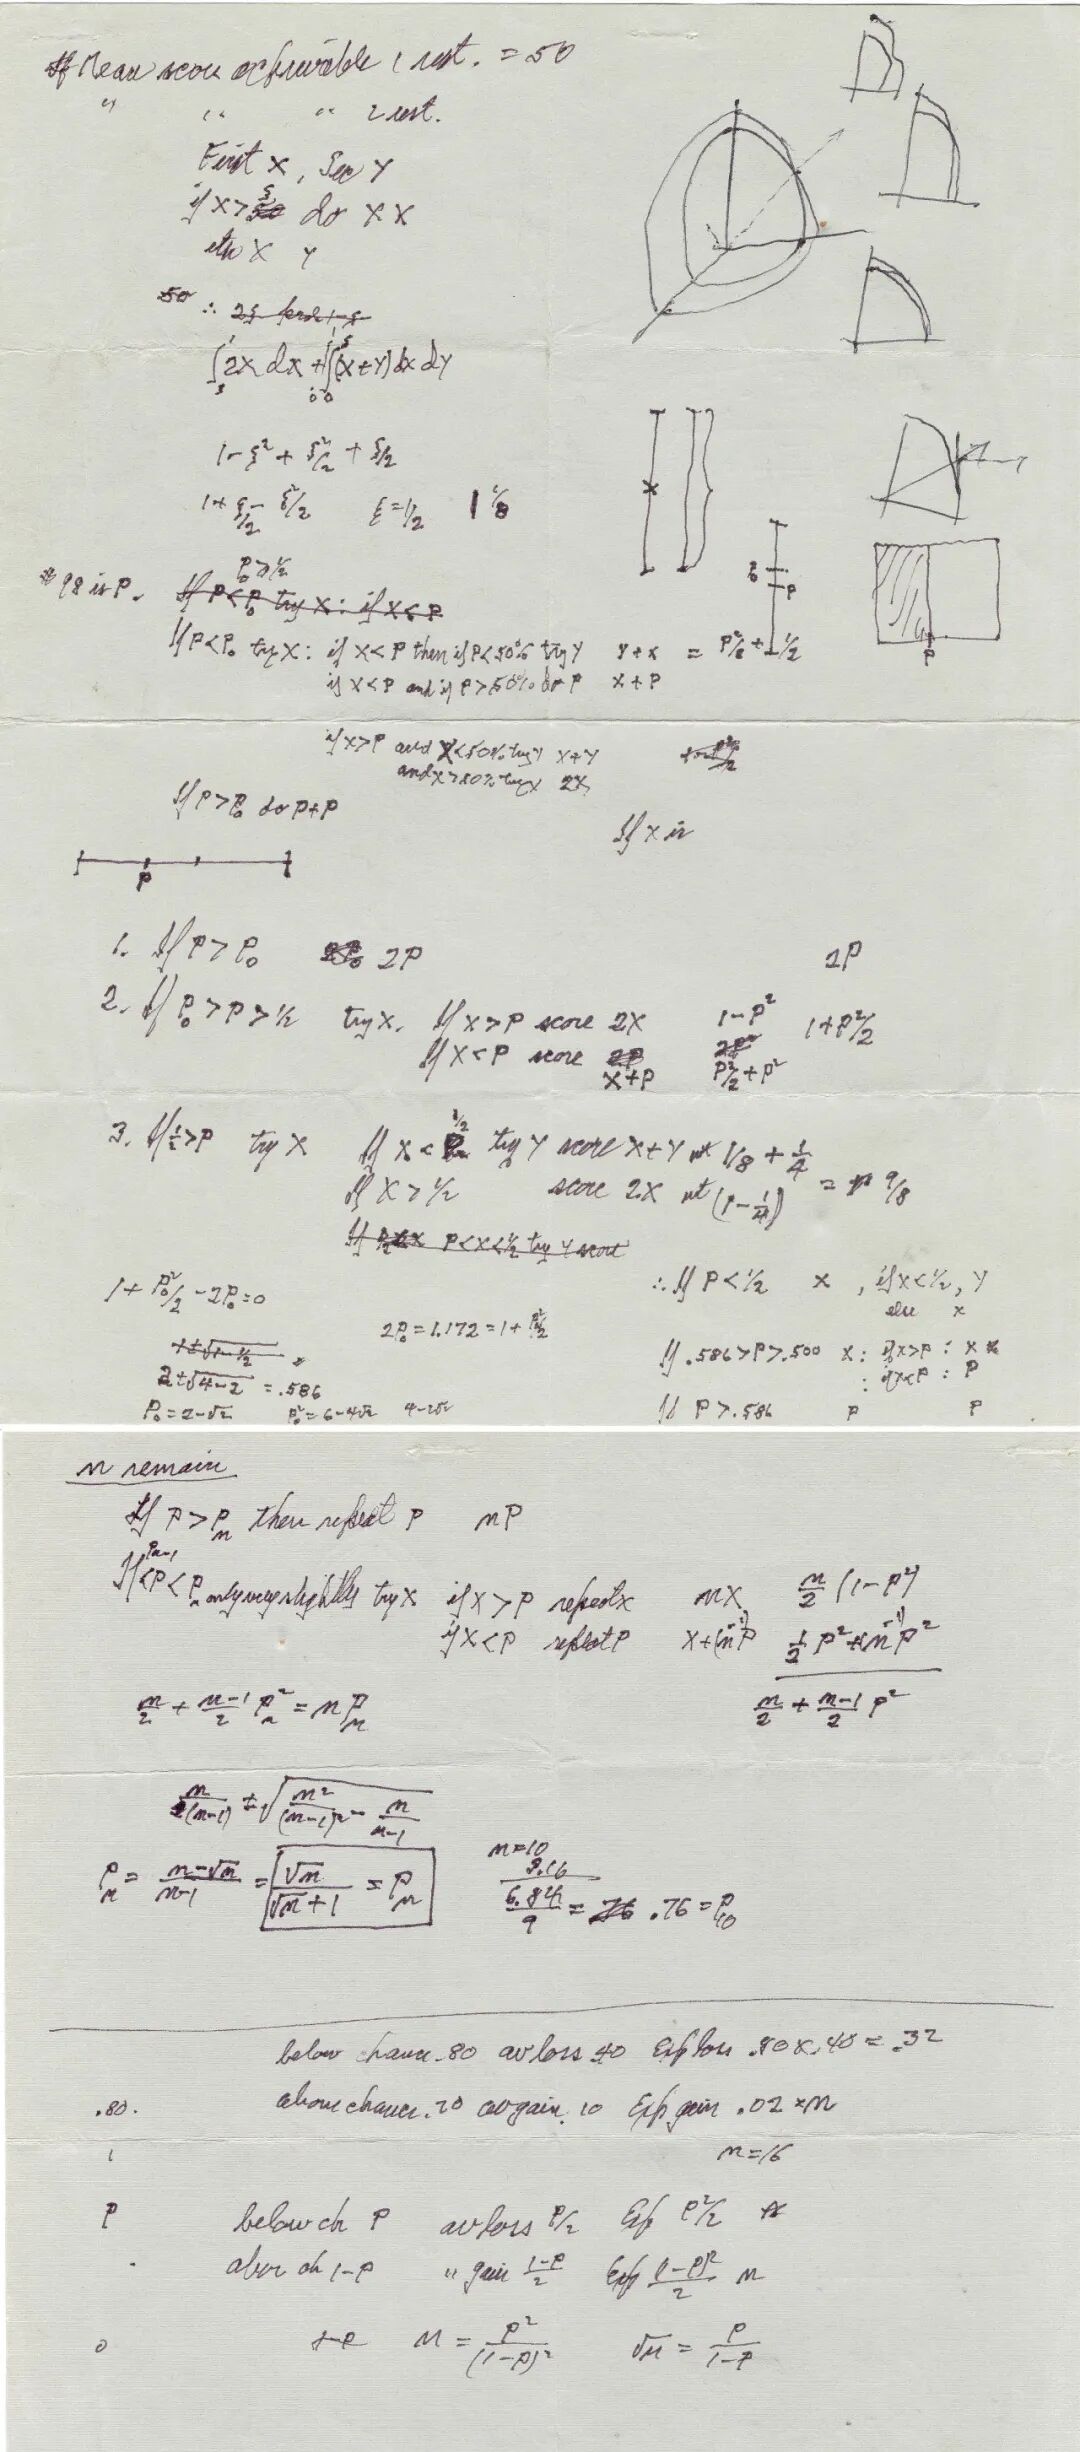
理查德·费曼手写的笔记。图片由拉尔夫·莱顿提供。参考来源[1]
时隔50年,计算认知科学家布莱恩·克里斯蒂安及其同事找到了这份演算底稿,解读出费曼这套精妙至极的点餐最优解法。相关成果日前在《美国国家科学院院刊》发表。
01
费曼推导出的最优就餐法则
当年费曼的研究原型为某一餐厅的菜品选择,论文团队将其等价转化为陌生城市多日就餐的模型:假设你要在一个城市待固定的天数,每晚二选一——尝试全新餐厅,或重返已找到的最优餐厅,每家餐厅有固定的质量评分,但只有去过才知道。参与者的目标是让全程的总满意度最大化。
论文还原了费曼的原始假设,菜品或餐厅评分服从均匀分布,他推导出动态阈值最优策略:仅当新菜品或餐厅的评分高于阈值,才值得选择;一旦遇到达标的菜品或餐厅,就停止探索,剩余均重复选择它。
这一策略的核心规律是:阈值随剩余天数的减少持续降低。这意味着,行程初期、还有很多次就餐机会时,要高标准、大胆探索;临近结束时,随着剩余就餐次数越来越少,要下调预期,优先复用已知的优质选项。
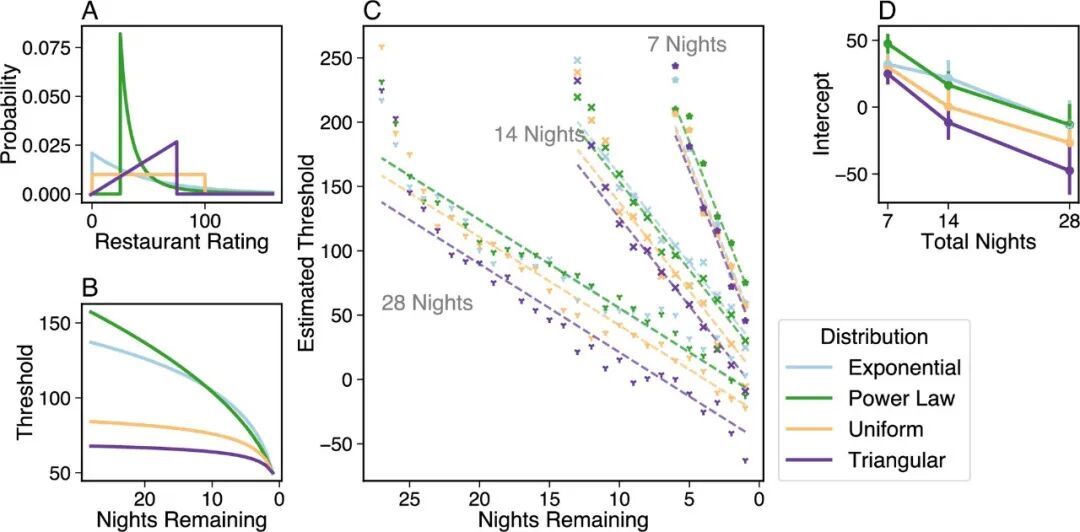
参与者使用线性但反映最优政策的阈值 参考来源[1]
研究进一步拓展了模型,推导出均匀、指数、幂律、三角这四类品质分布下的通用闭式最优解。无论评分符合哪种分布,最优策略均遵循“递减阈值”逻辑,只有阈值曲线的具体形态存在差异。
02
普通人的简化决策逻辑
为了测试人们的实际决策方式,研究团队开展了一项大规模在线行为实验:2520名参与者被分配到7或14或28晚的就餐周期,餐厅评分随机匹配4类分布,以累计总积分为评价标准。
实验观测表明,人们并不会使用费曼提出的那套复杂的非线性阈值,而是普遍采用线性递减阈值:评判标准随剩余尝试次数的占比匀速下降,且曲线斜率不受菜品评分分布的影响。
相较于线性模型的理论预测,受试者在决策初期的探索行为偏多,更愿意尝试新店。这套极简线性策略表现优异:参与者的最终收益与理论最优解非常接近。
论文指出,人类难以实时完成复杂概率运算,因此进化出线性简化的决策规则,在牺牲极小收益的前提下,大幅降低了思考成本,是一种兼顾效率与回报的实用折中方案。
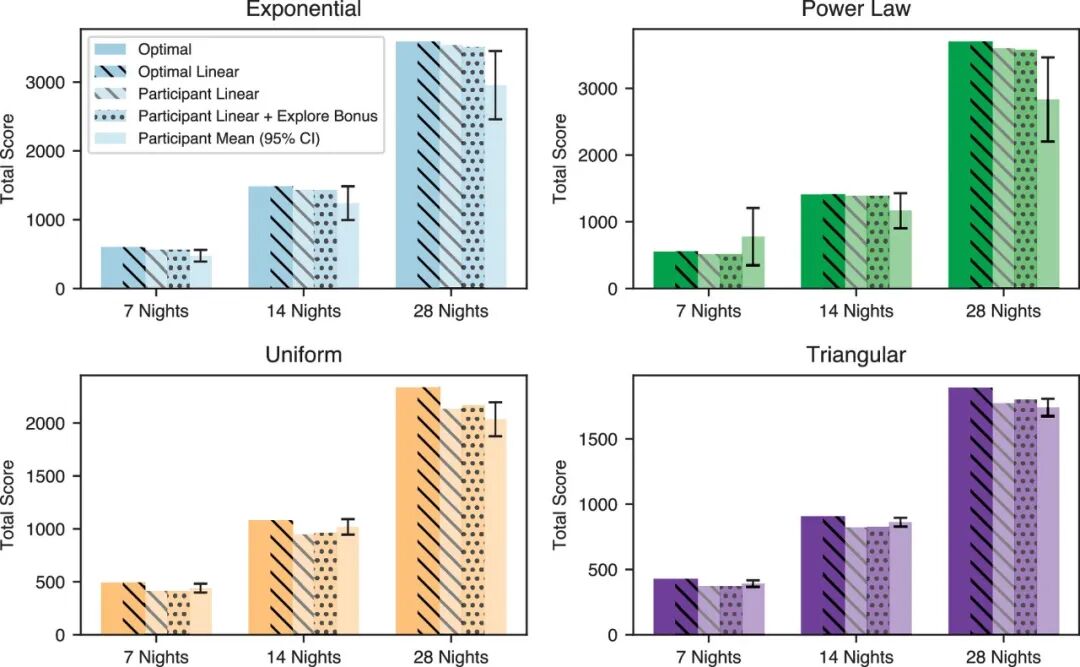
线性阈值实现近乎最优的性能 参考来源[1]
费曼餐厅问题属于“探索-利用”权衡下的最优停止问题,可迁移到很多需要持续平衡“尝试新机会”与“复用已有优质选择”的现实决策场景。
极端保守(从不尝新)、极端冒进(每晚都试新店)这两种策略的累计收益,均显著低于动态递减阈值策略,这是论文数值模拟与真人实验共同验证的结论。
日常决策中,我们不必强求完美计算,只需记住其核心逻辑:前期多探索、后期守优势,在尝试与深耕间找到动态平衡,就能实现长期收益的最大化。这或许就是费曼难题留给我们的启示。
数据图及参考来源:
[1]https://www.pnas.org/doi/10.1073/pnas.2509612123
[2]https://www.sciencenews.org/article/math-restaurant-meal-feynman
封面图:豆包AI生成